把工程图纸的零件表读准:一次 8B 视觉大模型 LoRA 微调的完整复盘
这篇写给两类人。 想了解「这件事对我们有什么价值」的读者,读每节开头带 📌 的段落就够了;想看工程细节的,往下读即可。全文所有数字都来自真实训练记录与评测报告,包括对我们不利的那些。
📌 先说结论
我们用 LoRA 微调了一个 8B 视觉语言模型(Qwen3-VL-8B-Instruct),让它把工程图纸里的零件明细表转成结构化 JSON。两轮训练(含第一轮规则错误的「学费」),算力按云端按需实例、以分钟计量,开销可控。
结果是:零件号、名称、规格、材料、数量五个字段,在合成留出集上从「基本读不对」变成「31 行全对」;描述文本的保真度从 0.51 提升到 0.9971,超过了未微调的基础模型。
但同一篇报告里也写着三件我们必须主动说出来的事:
- 第一轮的
train_loss低到 0.018,看起来完美无缺,实际上模型学错了——根因是我们数据脚本里的一行逗号切分规则。 - 后来做数据审计时发现,训练集和留出集有 2 处字节级重复。因此上面那些漂亮数字已从「独立准确率」降级为「历史诊断」,不再用于对外宣传。
- 视觉塔是冻结的,模型只学了「怎么把图变成 JSON」,没有学「怎么看图」。
如果一个团队只给你看第一条,不给后两条,那份报告不值得信。
一、我们要解决的是什么问题
离散制造企业(机加工、模具、钣金、3D 打印)拿到客户图纸后,第一件事是拆零件明细表:一行行读出零件号、名称、规格、材料、数量,再拿去核价、报价。一张 A3 图纸的明细栏动辄几十行,人工录入一张要 20–40 分钟,且极易出错。
传统做法是 OCR 识字 + 规则拼结构。问题是工程图纸的版式千差万别:跨页多栏、合并单元格、竖长表、扫描歪斜,规则写到最后是一坨补丁。
我们的判断是:这一环应该交给视觉语言模型,但不该交给通用大模型的 zero-shot。
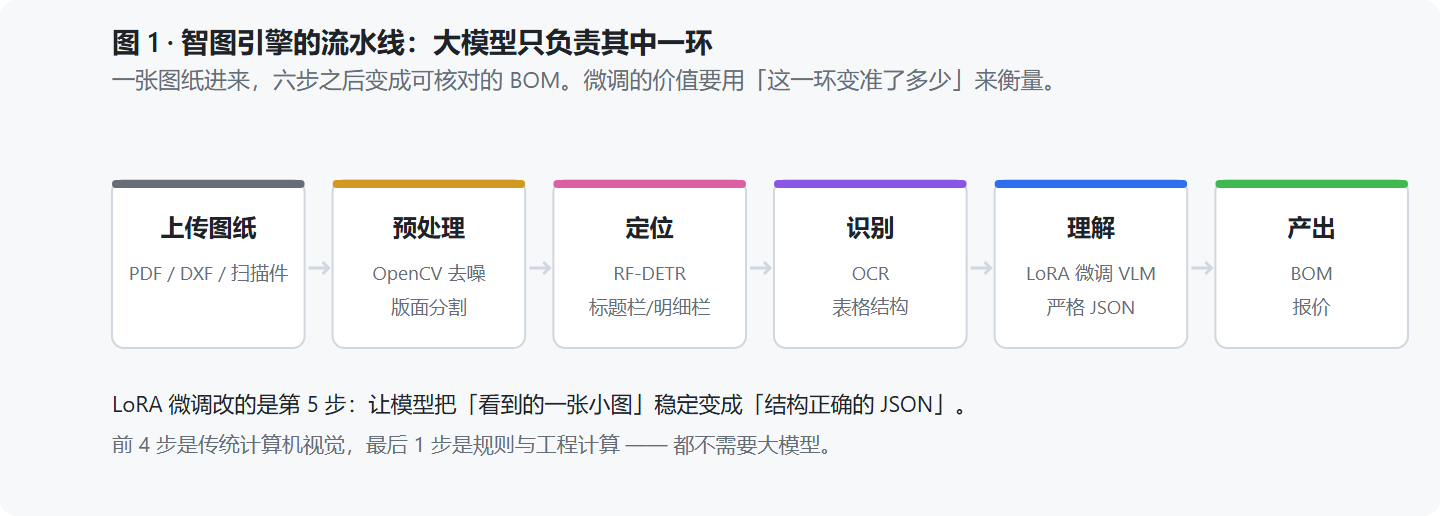
一张图纸从上传到产出 BOM,中间有六步。大模型只负责第五步——把「定位好的那一小块图」变成「结构正确的 JSON」。前四步是传统计算机视觉,最后一步是规则与工程计算。
这个划分很重要,因为它决定了微调的价值怎么衡量:不是「模型变强了多少」,而是「这一环变准了多少」。
为什么不让通用大模型直接读整页
我们做过对照:基础模型 zero-shot 确实能认出零件,但它把零件号塞进 spec 字段、把图号塞进 item_no 字段——内容读对了,位置放错了,在下游流程里等于零分。而它在「描述保真度」上反而很强,因为它会整段照抄。
这正是值得微调的典型形态:模型不缺能力,缺的是对我们 schema 的服从。
二、平台与硬件:卡在 28 GiB 这道门槛上
选卡的理由不是「越大越好」,而是一道硬门槛:8B 模型做 LoRA + bf16,实测需要约 28 GiB 显存。
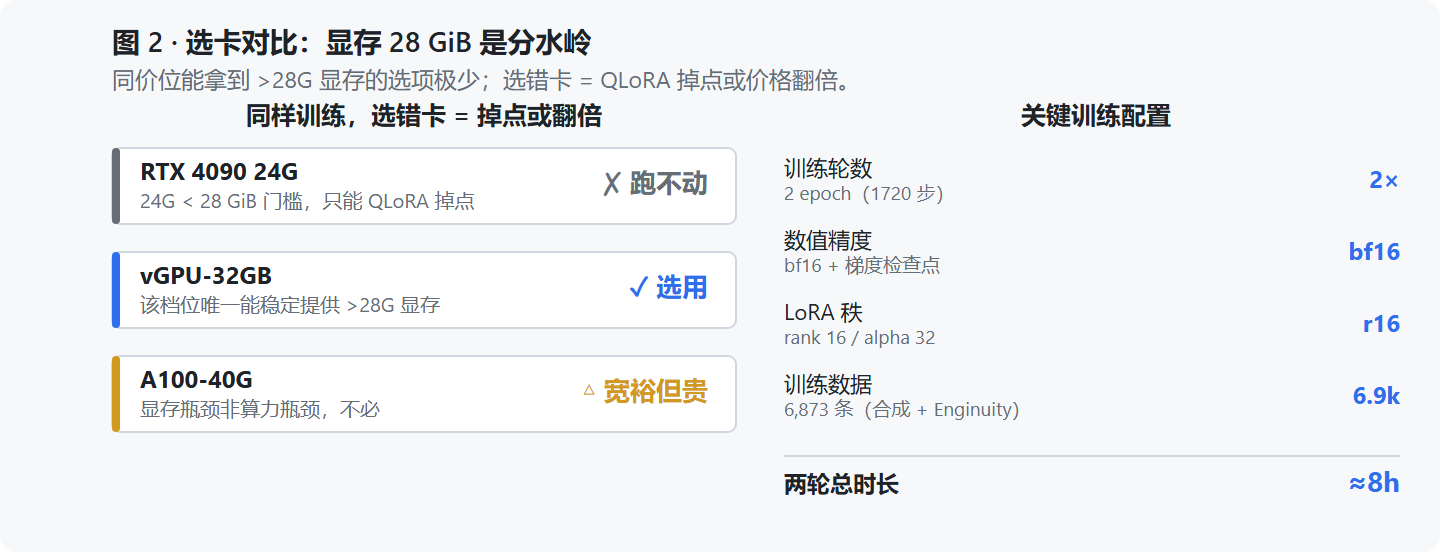
这道门槛把 24G 的卡全部挡在门外(RTX 4090 / 3090 都只有 24G,只能退而求其次做 QLoRA,掉点)。我们最终选了 vGPU-32GB(RTX 4080 SUPER / 32GB / Ada sm_89)——它是当时能稳定提供 28G 以上显存的按需实例。同档位的 V100-32GB 有三个 Volta 架构坑(不支持 bf16、不支持 FlashAttention-2、fp16 数值稳定性差),实测训练吞吐反而更低。
结论:这个任务是显存瓶颈,不是算力瓶颈。 半精算力只有 4090 的 62%,但训练时长几乎一样。
平台侧踩过的坑(都是真金白银)
| 坑 | 后果 | 处置 |
|---|---|---|
| 数据盘默认 50GB 不够 | 基模 17G + 数据集 4.1G + pip 环境 15–20G ≈ 40G,加上日志和 checkpoint 直接卡死 | 创建实例时就扩容到 150GB |
| 系统盘只有 30GB | 装 torch + CUDA 工具链会爆 | 环境装进数据盘,或直接用官方预装镜像 |
| CUDA 版本很新(13.x) | 自己 pip 装 torch 容易版本错配,pip install vllm 会连带把 torch 换成 2.13.0 + CUDA 13 | 用官方镜像;--dry-run 先看再装 |
| 余额不足会自动停机 | 训练跑到第 15 小时被停,checkpoint 虽可续,但白等 | 提前充值、留足余额 |
| GPU 数量选成 2 | 价格翻倍,而脚本是单卡的,第二张卡纯烧钱 | 选 1 |
三、数据选型:先想清楚数据集能喂什么、喂不了什么
我们没有一开始就找数据,而是先列了一张「能力映射表」:产品需要哪些字段,哪个数据集能提供监督信号。
| 产品需要的能力 | 公开数据集能给吗 |
|---|---|
| 明细表结构化(行/列还原、编号-件号-名称-数量分离) | ✅ 强,3,498 张表 |
| 跨页多栏、多表聚合 | ✅ 有 |
| 标题栏字段(图号/材料/比例/设计/审核) | ❌ 无,得自己合成 |
| 材料牌号识别 | ❌ 无 |
| 单重 / 重量计算 | ❌ 无(这是规则计算,不训) |
| 尺寸链 / 公差 / 干涉 | ❌ 无(保持纯 Python 规则) |
| 3D 精确几何重建 | ❌ 无(光栅单视图,无尺寸真值,训不出) |
一句话:Enginuity 是「表格理解」的燃料,不是「工程语义」的燃料。
我们最终用了 Enginuity(Apache-2.0,DOI 10.57967/hf/8702)——10 册公开美军技术手册(TM / RPSTL)的零件表图像与真值。选它有三个理由:许可干净可商用、真值是结构化 TSV 可直接用、论文基线公开可对标。
数据清洗:先减后加
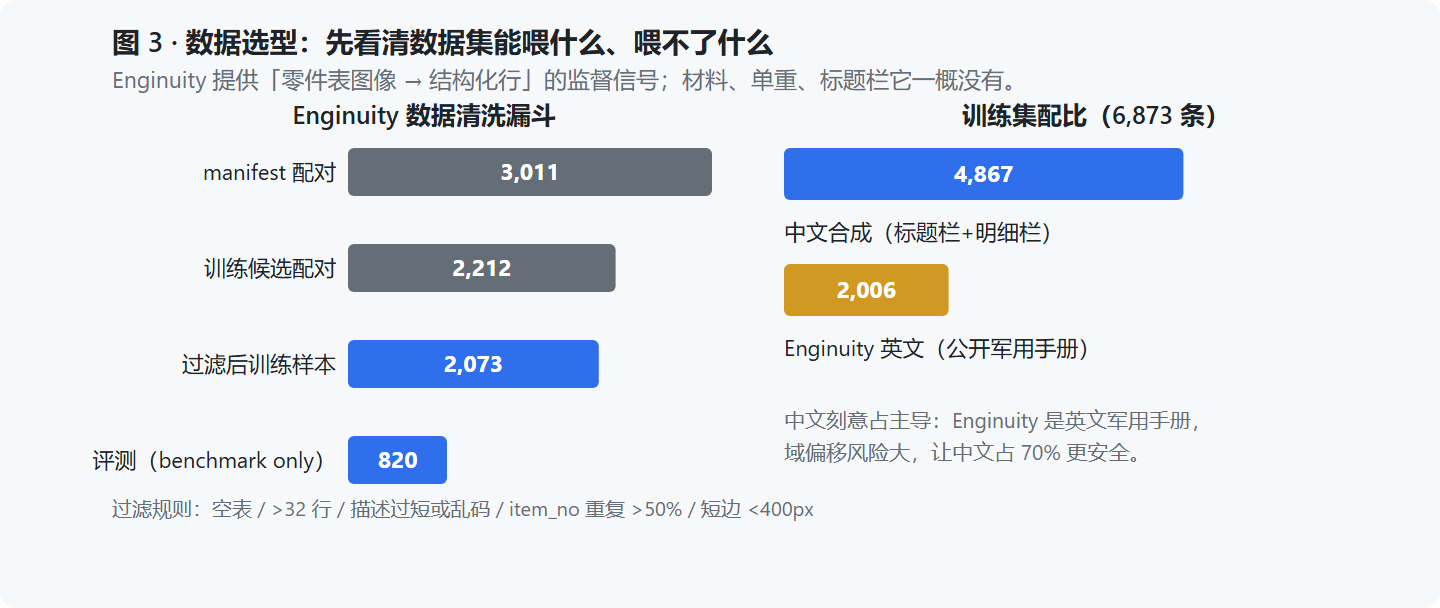
原始 manifest 有 3,011 个「图 ↔ 表」配对。按硬规则过滤后剩 2,073 个训练样本(26,683 个零件行),评测集单独取 820 个(15,409 行)。
过滤规则(硬闸门,宁缺勿滥):
- TSV 行数为 0(空表,实测大量存在)
- TSV 行数 > 32(超出
max_length,长尾论文里 mean 23、median 17) description长度 < 3,或非 ASCII 乱码比例 > 30%- 同一 TSV 内
item_no重复率 > 50%(结构还原失败) - 图像短边 < 400 px
然后只对训练集的图像侧做增强,label 不动:灰度化 + 对比度下降(30%)、JPEG 压缩 quality 40–70(20%)、高斯噪声 + 轻度模糊 σ1–3(20%)、小幅旋转 ±0.5°(15%,不能大角度,会破坏表格结构语义)、随机缩放 0.8–1.2(20%)。
配比:中文刻意占主导
最终 6,873 条训练样本里,Enginuity 英文只占 2,006 条,中文合成(标题栏 + 明细栏)占 4,867 条。
这是反直觉但必要的选择:Enginuity 是英文军用手册,域偏移风险极大。 美军 RPSTL 维修零件表 vs 中国 GB 机械图纸,语言、版式、字段全不同。让中文占 70% 更安全——宁可少学一点英文表格结构,也不能让模型在中文图纸上退化。
一个关键判断:不训端到端
现有检测节点已经能定位标题栏 / 明细栏 ROI,OCR 服务也已在链路里。所以我们把微调目标锁定为 「表格/标题栏 ROI 图 → 严格 JSON」,直接替换 extract 节点的 LLM 调用。整页直出只作对照实验,不作为主路线。
工程量最小、评测最干净、token 最省。
四、LoRA 是什么,以及我们怎么配的
给非技术读者: 完整微调一个 80 亿参数的模型,相当于把这栋楼每一层的承重墙都重砌一遍——贵、慢、容易塌。LoRA 的做法是:楼不动,只在每层加一副可拆卸的托架。 我们只训练 0.5% 的参数,就能让模型学会一套新的输出规范;不想用了,把托架拆掉,模型回到原样。
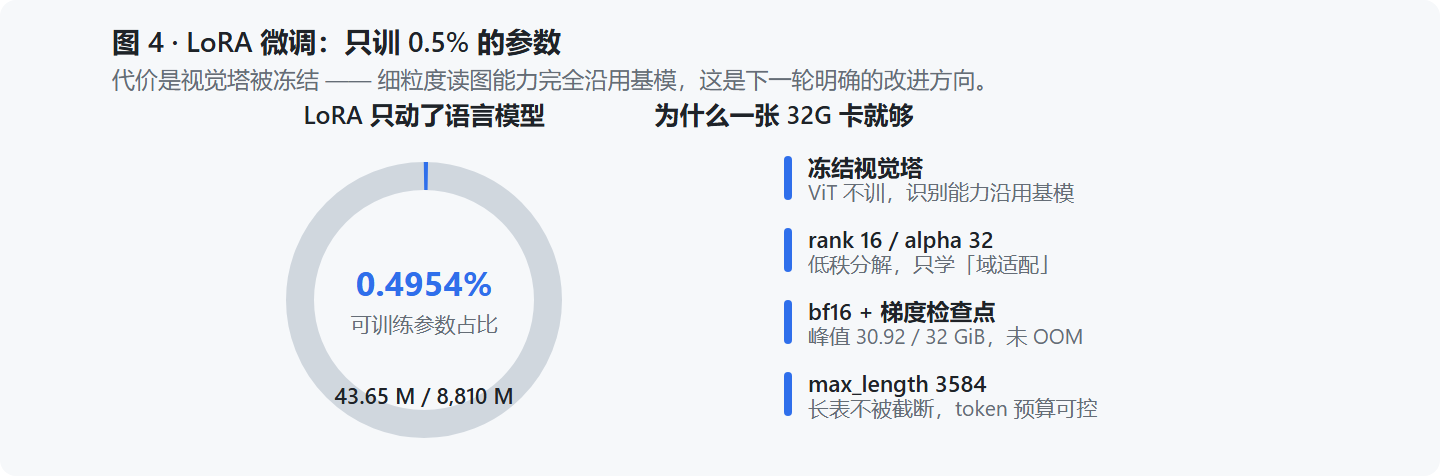
具体配置:
| 项 | 值 |
|---|---|
| 基模 | Qwen3-VL-8B-Instruct |
| LoRA rank / alpha / dropout | 16 / 32 / 0.05 |
| 目标模块 | all-linear(仅 language_model.*,不含视觉塔) |
| 可训练参数 | 43.65 M / 8,810 M = 0.4954% |
| 学习率 / 调度 | 1e-4,cosine,warmup 3% |
| epoch / batch | 2.0 / 1 × 8(梯度累积) |
| 精度 | bf16 + 梯度检查点 |
| 显存峰值 | 30.92 / 32 GiB(未 OOM) |
| 只算 assistant 段 loss | 是 |
⚠️ 必须同时说明代价:target_modules 的正则只匹配 language_model.*,视觉塔是冻结的。这意味着模型的视觉识别能力 100% 沿用基模——它没有变得更会看图,只是变得更会按我们的格式输出。下一轮想提升细粒度读图(小零件行、图号),解开视觉塔是明确方向,代价是显存需求上升(当前 vGPU 余量只有 1.84G,做不了)。
五、第一轮:train_loss 很漂亮,模型错了
这是整个复盘里最值得看的一段。
第一轮训练跑完,日志非常好看:
train_loss(末)   0.01802
token_acc(末段)  0.997
train_runtime      3h40m
0.018 的 loss,意味着 98.2% 的 token 准确率。 任何只看这条曲线的人都会宣布成功。
但 held-out 评测给出了完全相反的信号:
| 维度 | LoRA vs 基模 zero-shot | 判定 |
|---|---|---|
| 结构合法性(JSON 可解析) | 1.000 vs 1.000 | 持平 |
字段映射(零件号落到 item_no) | 0.979 vs 0.000 | ✅ 决定性提升 |
| 数量列 | 0.9962 vs 0.0000 | ✅ 决定性提升 |
| 描述保真(token F1,共同行) | 0.5678 vs 0.9573 | ❌ 负收益 |
在字段映射和数量上,LoRA 赢得干净利落;在描述保真上,它显著低于什么都没做的基础模型。
为什么低 loss 骗过了我们
必须纠正一个常见误诊:0.018 的 train_loss 不能说明过拟合。
因为输出是严格 schema 的 JSON,"spec":null,"material":null, 这类片段每行重复十余次,格式 token 近乎恒定。e^-0.018 ≈ 98.2% 的 token 准确率主要反映的是格式服从性,不是内容正确性。在这个任务上,低 train loss 是预期行为。
判断泛化只能靠 held-out 外部指标。
根因:脚本里的一行逗号
数据构造脚本 build_enginuity_sft.py 里有这样一个函数:
if "," in raw:
    name, rest = raw.split(",", 1)      # ← 问题在这里
这条规则假设「英文描述 = 名称,规格」——这是错的。 真实英文(美军 TM / RPSTL)零件描述的格式是 主名,限定语:
| 真值原文 | 规则产出的 name | 实际语义 |
|---|---|---|
WASHER,FLAT | WASHER | 主名 + 限定语 |
ENGINE,DIESEL 1996 6.5 LITER... | ENGINE | 主名 + 燃料类型 + 年份 |
FRAME ASSEMBLY USBL EFF 100,000 AND ABOVE | FRAME ASSEMBLY USBL EFF 100 | 千分位逗号被误当分隔符 |
三种错误同时发生:把限定语切走、千分位逗号被误切、切完的剩余部分被塞进 spec/remark——训练目标里的 description 从第一行起就是永久残缺的。
决定性证据:模型学得太好了
对 LoRA 匹配上的 812 行逐行比对:
| 类别 | 行数 | 占比 |
|---|---|---|
输出 == 训练规则的 name(即被截断的版本) | 731 | 90.0% |
| 输出 == 真值原文 | 71 | 8.7% |
这不是模型「没学会」,是模型「学得太好」——它精确复现了我们给它的错误标注。
也正因如此,这个缺陷在训练侧完全不可见(loss 一路降到 0.018),只有 held-out 外部指标 + 与基模同口径对比才能暴露。
顺带一个反直觉的观察:基模的「笨」在此处胜过了 LoRA 的「乖」。 基模没有这条先验,它整段照抄(.WASHER, FLAT),于是 F1 = 1.00。
六、第二轮:一行规则 + 一道闸门
修法很简单:name = raw 整段保留,逗号一律不作为切分依据;spec / remark 改为「附加抽取」——识别但不从原文删除。千分位逗号切分前先保护。
但修复之前先立闸门(tools/test_split_description.py):22 条硬编码断言 + 300 条真实抽样,全部通过才允许开训。
这道闸门是本轮没有再走弯路的直接原因——它只花几分钟,却省下了 4 小时 GPU。
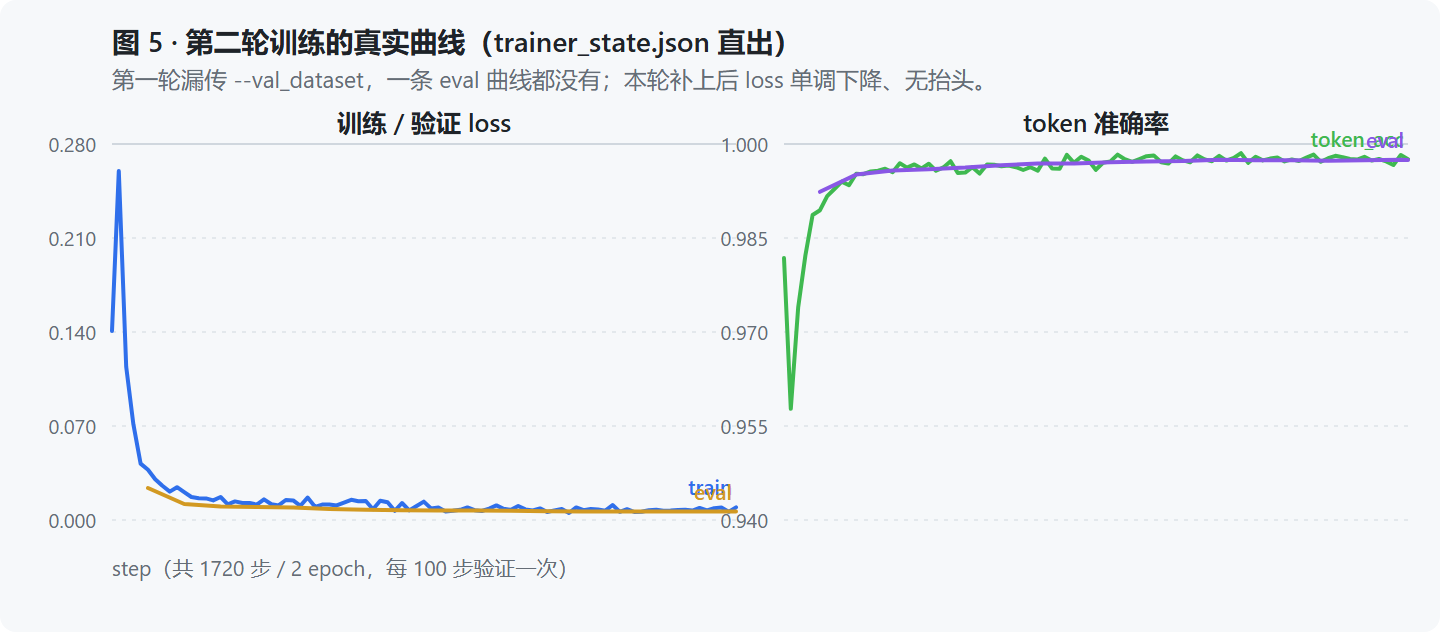
同时补上了第一轮遗漏的 --val_dataset mix_val.jsonl --eval_steps 100。第一轮一条 eval 曲线都没有,本轮 18 个验证点、loss 单调下降无抬头。
结果
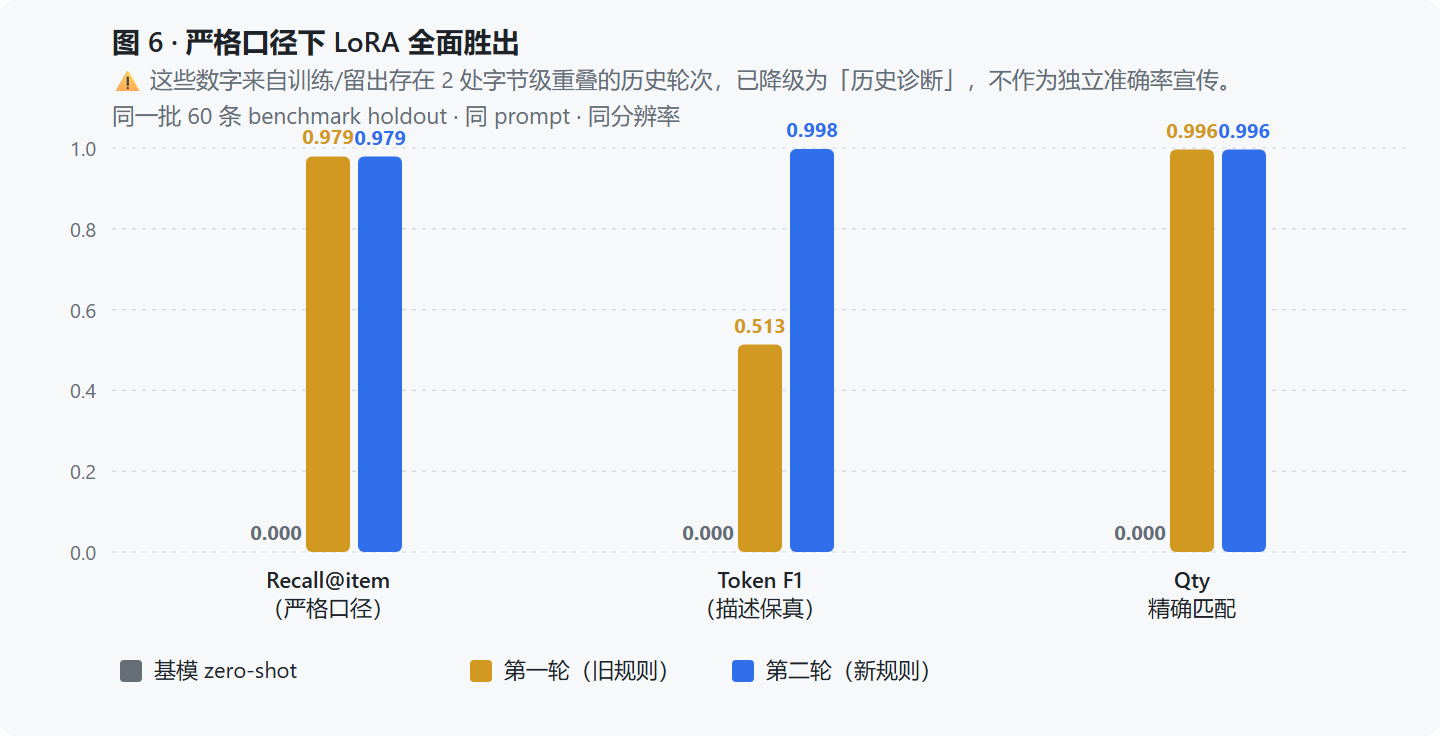
但单看这个表会误导——必须做共同行对比。
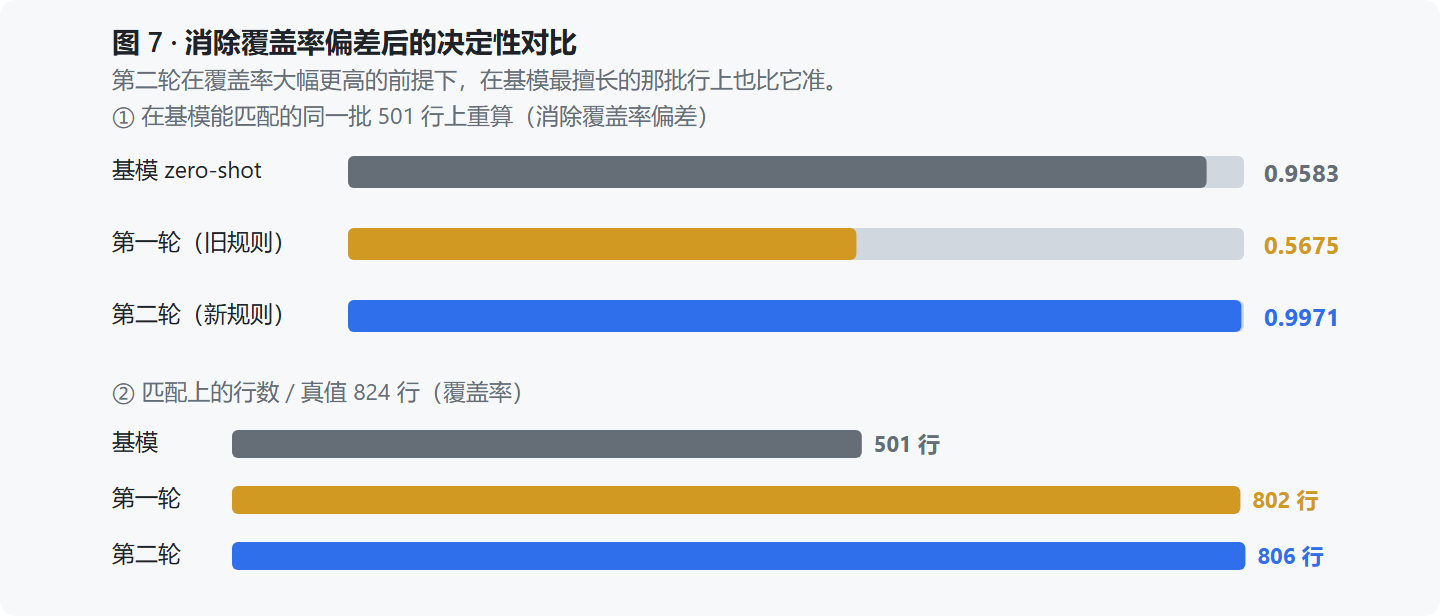
Token F1 只在各自匹配上的行上取平均。基模只匹配 501 行(都是容易行),LoRA 匹配 806 行(含大量难行),分母不同,不可直接比。在基模能匹配的同一批 501 行上重算:
| 模型 | 共同 501 行上的描述 token F1 |
|---|---|
| 基模 zero-shot | 0.9583 |
| 第一轮(旧规则) | 0.5675 |
| 第二轮(新规则) | 0.9971 |
结论:第二轮不仅在 61% 更高的覆盖率下工作,在基模最擅长的那批行上也比它准。
连真值的拼写错误都还原了
第二轮里最关键的一条证据:真值本身拼写是错的(FRAME ASEMBLY),模型输出 FRAME ASEMBLY——它如实还原了错误拼写,而不是按语义「纠正」成 ASSEMBLY。 这说明模型在读图,不是在猜。第一轮同一条被记作 FRAME ASY,属于读错。
成本
| 项 | 第二轮 | 第一轮 |
|---|---|---|
| train_runtime | 3h56m | 3h40m |
| train_loss | 0.01629 | 0.01802 |
| eval_loss | 0.00622(18 个点,单调下降) | 无(漏传参数) |
| 显存峰值 | 30.92 GiB | 30.55 GiB |
| best checkpoint | 1600(与 1700/1720 差异 1e-6,属噪声) | — |
| 费用 | 云端按需实例计费,两轮训练 + 评测开销可控 |
第一轮是学费。两轮合计按云端按需实例、以分钟计量,开销可控。
七、部署与实机调试:六个不试就发现的坑
权重训好只是开始。真正吃掉时间的是把它接进产品链路。
| # | 症状 | 真因 | 处置 |
|---|---|---|---|
| 1 | adapter 加载后推理慢 5 倍 | 未合并 LoRA | --merge_lora true:60 s/条 → 12–40 s/条 |
| 2 | prompt token 异常大(3748) | 推理分辨率没对齐训练的 max_pixels | 部署加 --max_pixels 786432;否则图片吃掉 3748 token,只剩 348 给输出,长 JSON 必被截断 |
| 3 | 指标近 0 但输出「看着对」 | finish_reason: length 截断 | 输出上限 ≥ 训练 p99(本任务 2408,max 3067) |
| 4 | 大量 __ERROR__timed out | 客户端并发 × 单条耗时 > 客户端超时 | --workers 1 + --timeout 900 |
| 5 | 请求全 200 但结果从未写出 | ThreadPoolExecutor 卡 futex_wait 不退出 | 改单线程 + 逐条落盘 |
| 6 | --max_model_len 不生效 | pt 后端忽略该参数 | 靠控制 prompt 长度,或换 vLLM |
还有一条方法论级别的:本项目累计出现过 5 次「验收工具本身写错」伪装成「被测对象故障」。 比如验收脚本硬编码了一个「近似」训练 prompt(没导入真 prompt)、只认 dict 不认 list、max_tokens 写死 2048——三个 bug 叠起来会把一个正常的端点误判为失败。
判定原则:结果异常时先自查工具链,再怀疑模型。
三层验收
| 层 | 验什么 | 结果 |
|---|---|---|
| L1 服务可达 | /v1/models 返回模型名 | ✅ |
| L2 训练口径 | 用训练时的同一份 prompt,9 个字段是否齐备 | ✅ 忠实复现训练 schema |
| L3 线上口径 | 产品真实 prompt 下能否解析 | ⚠️ 能解析,但 reconstruct 字段缺失 |
L3 的缺口说明一件事:线上 prompt 与训练目标不是同一个任务。 线上输入含 detections + OCR + table_kind + 历史修正,输出还要含三维几何;训练时是「单图 ROI → 表格 JSON」。直接接入会掉点。这是下一轮必须对齐的地方。
八、回归测试:四道闸门
训练完成不等于可以上线。我们设计了四道互相独立的闸门,每道都排除了「静默成功」——serve 侧 API 计数与用例数吻合、逐条 preds 是真模型输出而非模板兜底、n_api_error = 0。
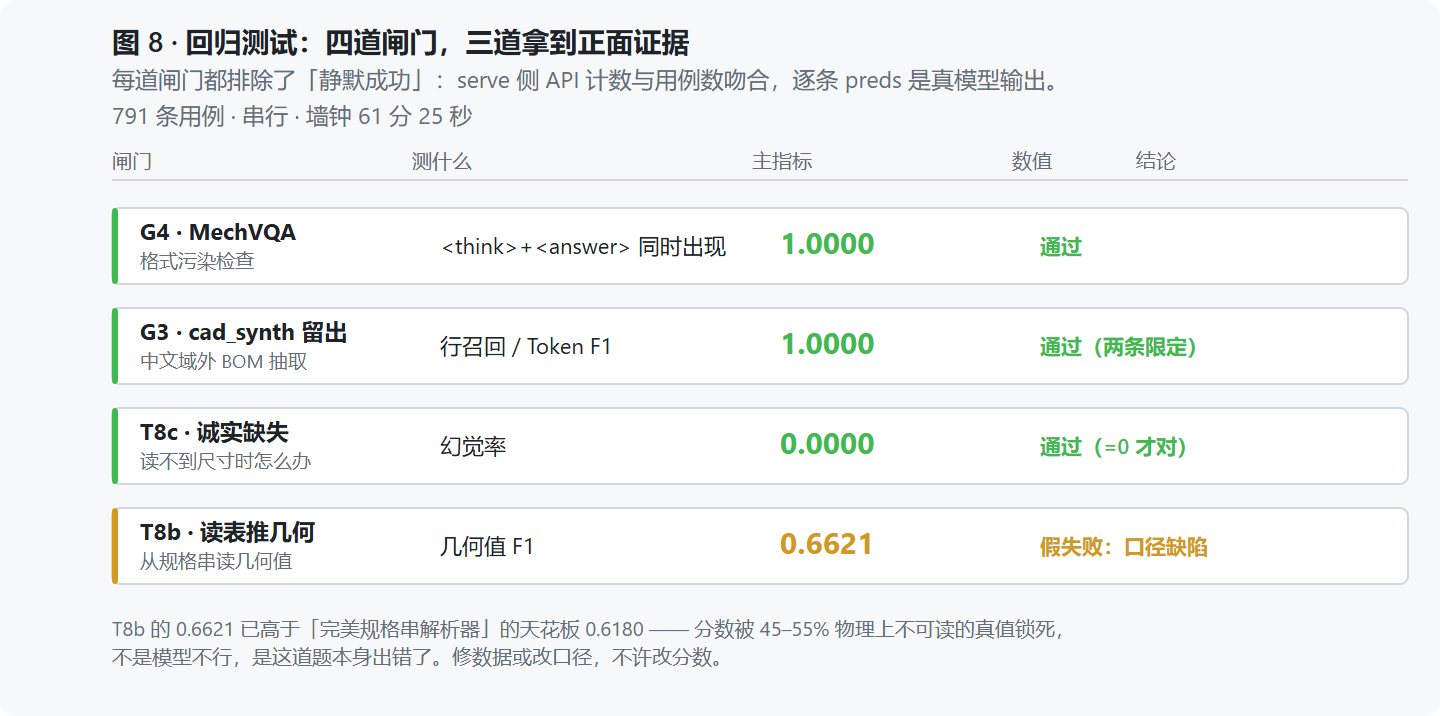
791 条用例,串行,墙钟 61 分 25 秒,云端按需计费、开销可忽略。
T8b:0.6621 是一次「假失败」
这道闸门测「从规格串读出几何值」,得分 0.6621。表面看不及格,但三条证据表明问题出在数据和口径,不在模型:
证据一,直接看图。 样本 s0000.png 的视图上一个尺寸标注都没有,只有明细栏给了 3 个数(δ8×100×80)。而真值里 支架 的 geometry 是 {base_len:100, wall_height:80, width:60, thickness:8, hole_dia:6, hole_count:2}——width:60 和 hole_dia:6 在图上和规格串里都不存在。
证据二,全量统计(4,506 个真值几何值 / 751 个零件):
| 分类 | 数量 | 占比 |
|---|---|---|
| 出现在本零件规格串里(可读) | 2,015 | 44.7% |
| 不在本零件、但出现在本图其他规格里(大概率数字撞车) | 571 | 12.7% |
| 图上与串里都读不出来 | 1,920 | 42.6% |
按几何键拆开更清楚:thickness / base_len / wall_height / length / outer_dia 可读率 100%,而 hole_dia / hole_count / fillet / inner_dia / bolt_dia / bolt_circle_dia 可读率 0%——它们全是 CAD 生成器的派生量,图上一个标注都没有。
证据三,算天花板。 让一个「完美的规格串解析器」上场(把规格列数字原样抄下来,绝不看图、绝不编造),按同一口径得分:
几何值 P = 1.0000 R = 0.4472 F1 = 0.6180
模型拿了 0.6621——已经略高于天花板。 这道闸门不可能通过「让模型更会看图」来提升,分数被 45–55% 不可读的真值锁死。
修正口径后重算(post-hoc 诊断,非官方指标):
| 诊断项 | 值 |
|---|---|
| 可读真值召回 | 90.7%(1991 中命中 1805) |
| 模型给出规格串值的精确率 | 100.0%(1805/1805) |
| 对「读不出的值」的猜中率 | 53.1%(2461 中命中 1308,按图形比例反推) |
判定:假失败。修数据或改口径,不许改分数。 具体做法是把真值限制到「规格列可推出的键」,或在图上补尺寸标注——如果产品目标包含「看图量尺寸」,就必须做后者。
线上实测:瓶颈不在模型
把微调后的模型接进产品跑了 19 次串行新解析:
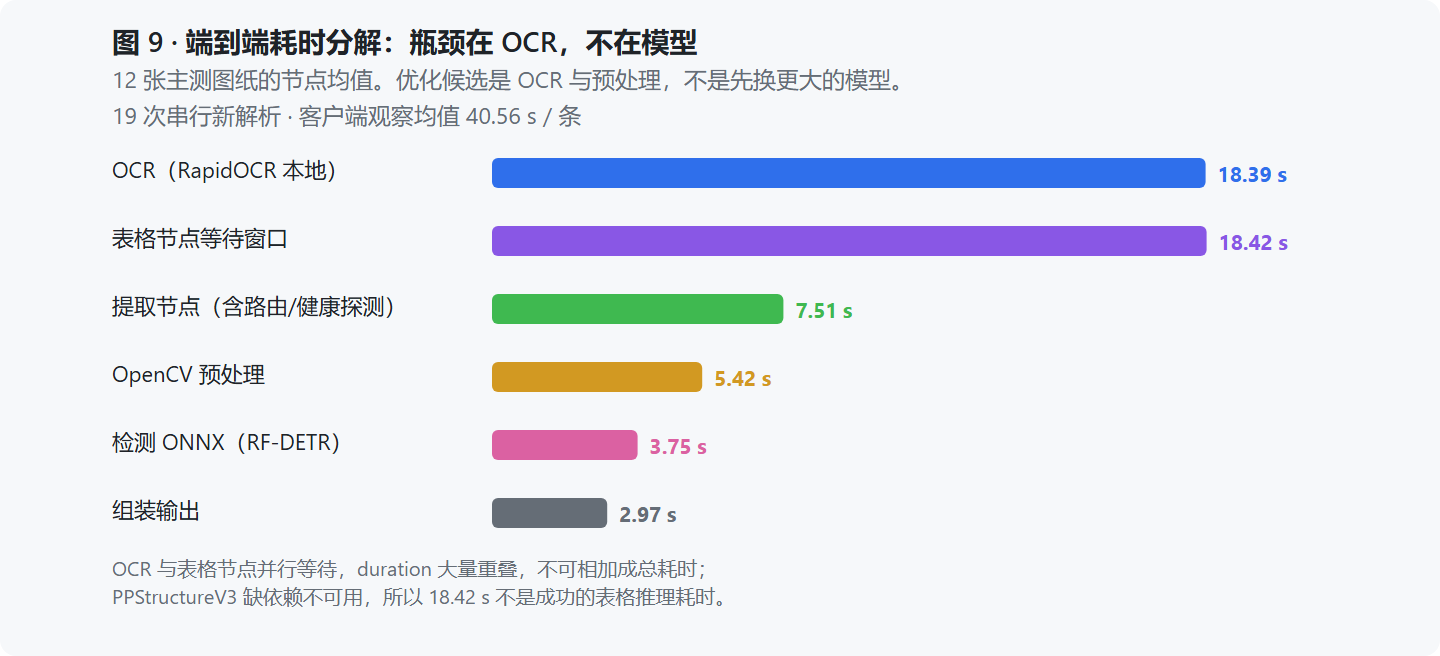
- 主测 12 张合成图纸共 31 行:五字段完整行 31/31,加入单重后 18/31(58.1%)
- 标题栏只有 8/84 个字段匹配——当前只给模型明细栏 ROI,标题栏能力明显不足
- 单次缓存复用约 41 ms(不能用缓存速度代表模型推理)
- 相同图纸重跑两次,items 完全一致——稳定复现,包括稳定复现了错误的单重
同时也暴露了真实缺陷:
- 白图(无明细表)生成了 3 条虚构明细。 根因是 PDF/DXF 路由下
images=0,而trained档位构造消息时既不带图也不带文本,却依然调用模型。这 5 个任务都返回了同样的MP-01/02/03 Connecting Strip,规格、材料、数量、单重完全一致——与真值不符,白图更完全没有这些内容。 - 生效表格配置是 PPStructureV3,但容器缺
paddleocr,实际输出ppstructurev3_unavailable——而任务状态仍然显示done、degraded=false。 - 3D 默认底板出现在 7/19 个 assembly 产物中;washer 的网格是实心柱(忽略内半径);GLB 未恢复工程米制(480 mm 底板导出约 4.8 场景单位)。
这些都不是「下次注意」级别的问题。 空白输入必须阻断生成,状态位必须反映真实能力。
九、必须说清楚的两件事
1. 训练/留出重叠,旧指标已降级
第一轮报告曾写「评测集与训练集零重叠,无泄漏」。2026-10-15 的数据审计推翻了这个结论:
对 enginuity.jsonl(2,073 行)和 enginuity_holdout.jsonl(820 行)做路径归一与 SHA-256 比对:
- 缺失图像引用:0
- 训练/留出 exact image hash overlap:2 个哈希
data-2/tables/page_270.png在训练中重复引用 3 次,且也出现在留出data-1/tables/page_78.png与page_83.png文件名不同但字节相同
- 原始 payload 层面还有大量重复:6,484 个图像文件中 129 个重复,3,585 个 TSV 中 961 个重复
结论:历史文档中的「训练/验证无重叠」不能作为当前独立留出的证明,旧 Enginuity 指标降级为历史诊断。
这也是本文中所有 0.99xx 数字都带 ⚠️ 标注的原因。已修正 build_enginuity_sft.py:新的 holdout fence 同时按 figure path、table path 和 table bytes hash 三重排除。未重训、未重建旧 JSONL、未把修复后的结果虚报为新指标。
2. 合成数据不是真实企业图纸
四闸门里的 G3 拿了满分,但它有两个限定必须一起说:
- 这是合成图(与规则生成器同源),只证明「合成分布内不掉」,不是真实图纸的证据
- 真留出只有 8 条(±1 行就能翻盘),不能当上线门槛
线上实测的 17 张有正样本真值的图纸,49 行真值 / 47 行输出,严格完整行 20 行:precision 42.6%、recall 40.8%。这个数字远低于合成集上的表现——这才是更接近真实的区间。
十、沉淀下来的方法论
| 判断 | 证据 |
|---|---|
| 数据规则错误在 train_loss 上完全不可见 | 第一轮 loss 0.018 / token_acc 0.997,看着完美,实际描述保真 0.51 |
| 必须与未微调基模同口径对比 | 只和「自己上一轮」比看不出问题;和基模比才发现 0.51 < 0.96 |
| 必须补「共同匹配集合」上的对比 | 否则覆盖率偏差会让结论反转 |
| 改规则前先写断言集 | 几分钟闸门省下 4 小时 GPU |
| 模型会忠实复现你的标注错误 | 90% 的输出是错误规则的产物——它学得没错,是标注错了 |
| 结果异常先自查工具链 | 5 次「验收工具写错」伪装成「被测对象故障」 |
| 分母不对,指标就是谎言 | 共同行集合、可读子集、白图不进正样本分母 |
附:复现命令
# 1) 改规则后先过断言(不过就不许开训)
python tools/test_split_description.py --sample 300

# 2) 重建数据(英文侧,holdout 三重 fence)
python tools/build_enginuity_sft.py
python tools/build_enginuity_sft.py --holdout-mode only --out data/sft/enginuity_holdout.jsonl

# 3) 冒烟 → 正式训练(带验证集)
BASE_MODEL=/root/autodl-tmp/models/Qwen3-VL-8B-Instruct GPU_MEM=32 bash tools/train_vlm.sh smoke
BASE_MODEL=/root/autodl-tmp/models/Qwen3-VL-8B-Instruct GPU_MEM=32 bash tools/train_vlm.sh train

# 4) 起服务(合并 adapter + 分辨率对齐训练)
CKPT=/root/autodl-tmp/out/zhitu-vlm-8b/v1-20261010-212620/checkpoint-1720
swift deploy --model /root/autodl-tmp/models/Qwen3-VL-8B-Instruct \
  --adapters $CKPT --merge_lora true --infer_backend pt --port 8000 \
  --served_model_name zhitu-vlm-8b --max_new_tokens 3584 --max_pixels 786432

# 5) 评测(预测逐条落盘,改指标可离线重算,不烧 GPU)
python tools/eval_enginuity.py --model zhitu-vlm-8b --split benchmark \
  --limit 60 --workers 1 --timeout 900 --max-tokens 3584 \
  --out data/sft/eval_lora_v2.json
适配器权重(adapter_model.safetensors 174,663,096 字节)是唯一不可重建的产物——基模、数据集、合成数据都能重新生成,训练 4 小时的权重不能。换机器时注意 adapter_config.json 里 base_model_name_or_path 写的是远端绝对路径,需要改成新机器的路径。
本文所有训练曲线、指标、耗时与成本数字均来自 trainer_state.json 与项目内评测报告的实测记录。涉及不利结论的部分(训练/留出重叠、白图幻觉、3D 非工程级、指标降级)未做修饰。